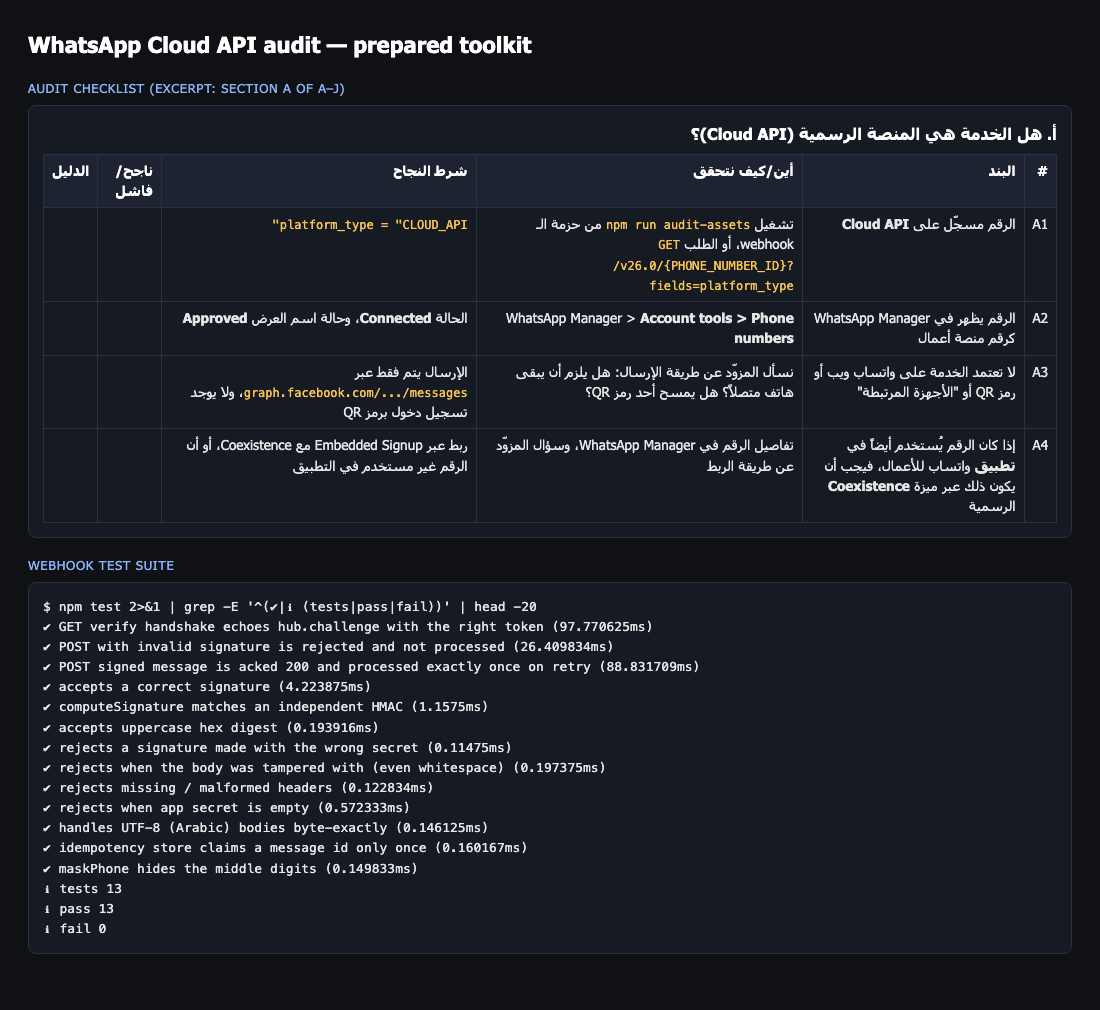
13/13اختباراً ناجحاً
تدقيق واتساب Cloud API وWebhook آمن
أداة تكشف هل ربط واتساب رسمي فعلاً وباسم من، وWebhook يتحقق من توقيع Meta ولا يعالج الرسالة مرتين.
تشخيص بطء نموذج محلي، والسبب لم يكن العتاد بل ذاكرة Swap ممتلئة. ثم ضبط وقياس نحو 20 نموذجاً.
النتيجة المقاسة
6 → 37
رمزاً في الثانية
نموذج MoE بحجم 35 مليار معامل على سيرفر منزلي ببطاقة GTX 1650 (4GB) كان يولّد 6 رموز في الثانية فقط، وأغلب إعدادات التشغيل معطلة.
13/13اختباراً ناجحاً
أداة تكشف هل ربط واتساب رسمي فعلاً وباسم من، وWebhook يتحقق من توقيع Meta ولا يعالج الرسالة مرتين.
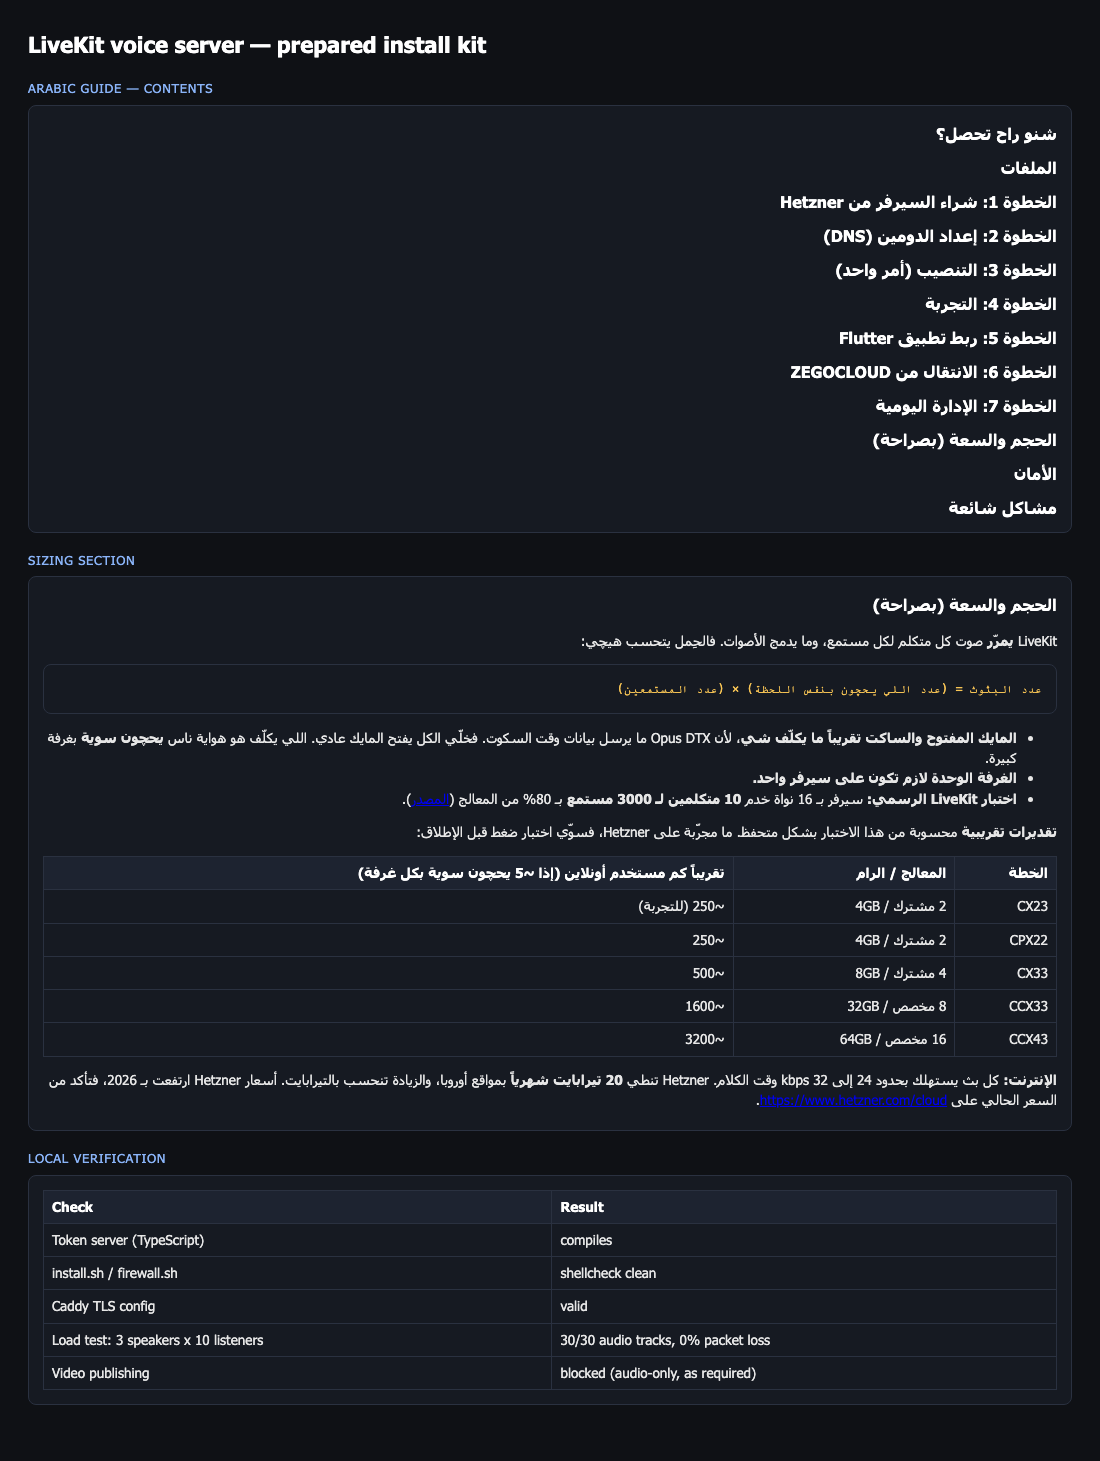
30/30مساراً صوتياً، خسارة 0%
غرف صوتية على سيرفر خاص بدل الدفع بالدقيقة، بتثبيت بأمر واحد وتوكنات للصوت فقط.
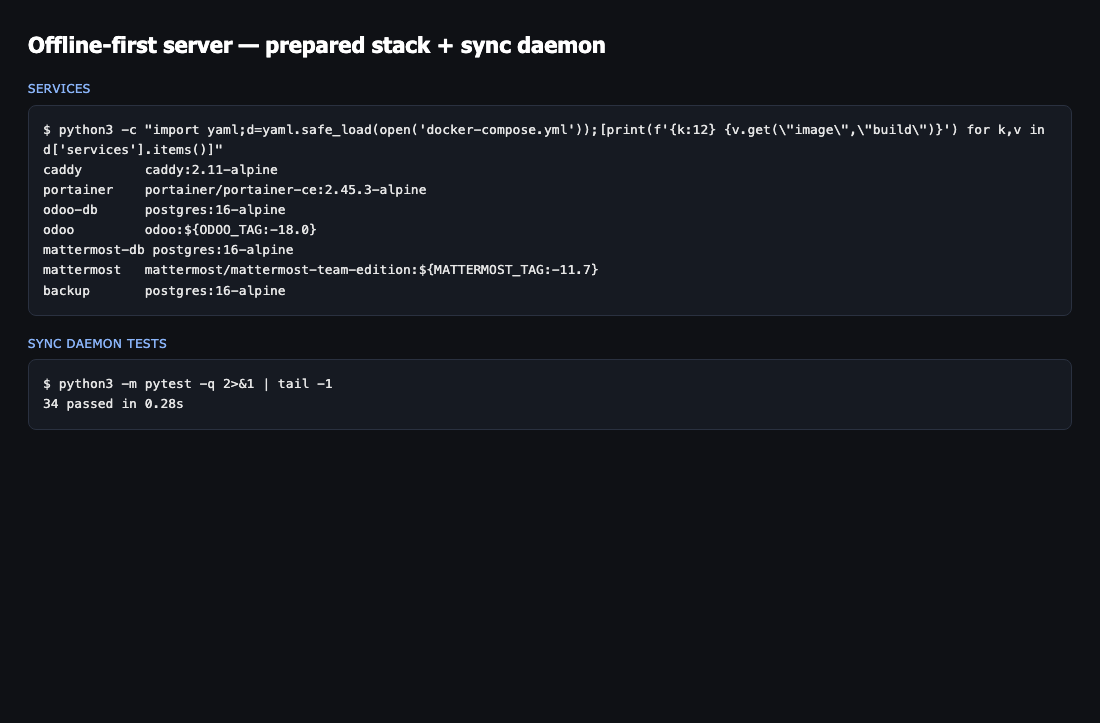
34اختباراً ناجحاً
يعمل المحل على Odoo محلي دائماً، وخدمة في الخلفية ترفع الفواتير والعملاء للسحابة عند عودة الإنترنت دون تكرار.